引言 深度学习中常常用到归一化运算,身为炼丹师,常不加思索地直接 copy 别人的结构,cooking 魔改,一直没有深入地理解这个运算的意义作用,为此本文总结了本人对这一技术的浅淡理解。
归一化的作用
在深度学习中,神经网络每一层的输出神经元可视为一组激活向量,数值大小即各神经元的激活值,而这一数值的大小受上一层激活值与连接该层的突触权重影响。倘若激活值偏大或偏小,容易使下一层的激活向量发生偏移,并随着层数增大,该偏移逐渐放大,最终导致深层输出分布异常,影响输出逻辑。
从概率分布的角度看,把每一层的激活值记作一个随机变量 $x$,问题就变成了分布的形状在不断漂移:随着前一层参数更新,本层输入分布的整体均值、方差会逐层变化,使得本层需要不断去"追逐"一个移动的目标分布。这种现象被称为内部协变量偏移(Internal Covariate Shift)。它带来的直接后果是:梯度在层间传播时尺度难以稳定,浅层梯度消失、深层梯度爆炸,训练只能依赖极小的学习率,收敛缓慢。[^1]
为此,在每一层传递的过程中需要加入归一化的操作,将激活数值重新缩放到标准范围内,避免数值大小偏移随层数深入而被放大。需要澄清一点:归一化严格来说并非把数值压缩到 $[0,1]$,而是把每个数变换到零均值、单位方差的标准正态尺度上;且变换后还会再经过一对可学习参数 $\gamma,\beta$ 做仿射变换,因此最终取值范围并不被限制在 $[0,1]$ 之内(这与 Sigmoid 之类的饱和函数是有本质区别的)。
归一化在做什么
几乎所有归一化层都遵循同一种"三步走"范式,可统一写成下式:
$$
Y = \frac{X-\mathrm{E}[X]}{\sqrt{\mathrm{Var}[X]+\epsilon}}\cdot\gamma+\beta
$$ 其中各项含义为:
- $X$:待归一化的张量(某层线性/卷积输出);
- $\mathrm{E}[X]$、$\mathrm{Var}[X]$:在选定的维度集合上计算的均值与方差;
- $\epsilon$:防止分母为零的极小常数(如 $10^{-5}$);
- $\gamma,\beta$:可学习的缩放与平移参数,维度与该维度上的通道数对齐;
- $Y$:归一化后的输出。
三个步骤:
- 中心化:减去均值 $\mathrm{E}[X]$,把分布平移到原点附近;
- 标准化:除以标准差 $\sqrt{\mathrm{Var}[X]+\epsilon}$,把分布缩放成单位方差;
- 仿射重映射:乘以 $\gamma$ 加 $\beta$,把被"抹平"的表达能力还给网络。
为什么这一招有效
- 稳定分布、加速收敛:每层输入被重新拉回同一尺度,缓解了内部协变量偏移,于是可以使用更大的学习率,收敛更快。[^1]
- 平滑损失曲面:归一化使损失函数对参数的变化更不敏感(Lipschitz 常数更小),梯度更"规矩",优化过程更稳定。[^2]
- 起到轻微正则作用:在 Batch Norm 中,由于每个样本的归一化统计量都依赖于同一批次中的其他样本,训练时引入了噪声,具有一定正则效果,因此有时可以减弱甚至去掉 Dropout。[^1]
对"作用"一句话概括:归一化的本质,是主动设计每层激活的统计分布(均值、方差),从而在层与层之间"解耦",让每一层都在一个稳定、可预期的输入尺度下学习。 至于保留哪些维度、抹平哪些维度,则取决于下面不同归一化方法对"归一的轴"的选取。
常见的归一化方法
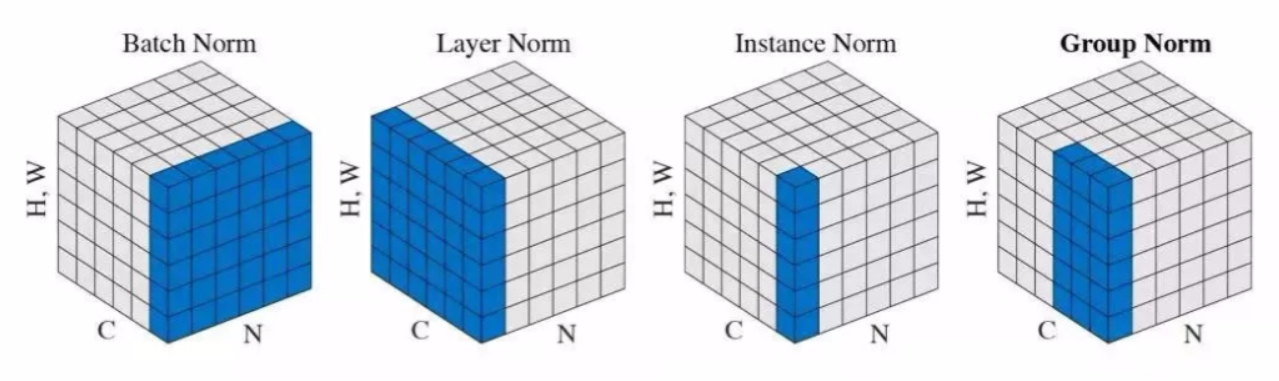
记一个 mini-batch 的输入张量为 $X\in\mathbb{R}^{N\times C\times H\times W}$,其中 $N$ 为批大小、$C$ 为通道数、$H\times W$ 为空间尺寸(对全连接层可理解为每层神经元数)。不同归一化方法的区别,就在于沿着哪些轴求统计量:
| 方法 | 归一化维度 | 公式 | 适用场景 |
|---|---|---|---|
| Batch Norm | $(N,H,W)$,即每通道跨样本 | $y=\dfrac{x-\mu_{c}}{\sqrt{\sigma_{c}^{2}+\epsilon}}\gamma_{c}+\beta_{c}$ | 大 batch 的 CNN 图像任务 |
| Layer Norm | $(C,H,W)$,即每个样本内部 | $y=\dfrac{x-\mu_{n}}{\sqrt{\sigma_{n}^{2}+\epsilon}}\gamma+\beta$ | Transformer、RNN、小 batch / 序列任务 |
| Instance Norm | $(H,W)$,即每样本每通道 | $y=\dfrac{x-\mu_{n,c}}{\sqrt{\sigma_{n,c}^{2}+\epsilon}}\gamma_{c}+\beta_{c}$ | 风格迁移、图像生成 |
| Group Norm | $(C/G,H,W)$,即每样本按通道分组 | $y=\dfrac{x-\mu_{n,g}}{\sqrt{\sigma_{n,g}^{2}+\epsilon}}\gamma+\beta$ | 小 batch 的检测 / 分割 |
-
Batch Norm:统计量在通道 $c$ 上跨 $N,H,W$ 求均值与方差,
$$
\mu_{c}=\frac{1}{NHW}\sum_{n,h,w}X_{n,c,h,w},\qquad \sigma_{c}^{2}=\frac{1}{NHW}\sum_{n,h,w}\left(X_{n,c,h,w}-\mu_{c}\right)^{2}
$$ -
Layer Norm:统计量对样本 $n$ 在 $C,H,W$ 上求均值与方差,
$$
\mu_{n}=\frac{1}{CHW}\sum_{c,h,w}X_{n,c,h,w},\qquad \sigma_{n}^{2}=\frac{1}{CHW}\sum_{c,h,w}\left(X_{n,c,h,w}-\mu_{n}\right)^{2}
$$ -
Instance Norm:统计量在样本 $n$ 的通道 $c$ 内对 $H,W$ 求均值与方差,
$$
\mu_{n,c}=\frac{1}{HW}\sum_{h,w}X_{n,c,h,w},\qquad \sigma_{n,c}^{2}=\frac{1}{HW}\sum_{h,w}\left(X_{n,c,h,w}-\mu_{n,c}\right)^{2}
$$ -
Group Norm:将 $C$ 个通道划分为 $G$ 组,统计量在样本 $n$ 的组 $g$ 内对 $C/G,H,W$ 求均值与方差,
$$
\mu_{n,g}=\frac{1}{(C/G)HW}\sum_{c\in g}\sum_{h,w}X_{n,c,h,w},\qquad \sigma_{n,g}^{2}=\frac{1}{(C/G)HW}\sum_{c\in g}\sum_{h,w}\left(X_{n,c,h,w}-\mu_{n,g}\right)^{2}
$$
四者的关系可以这样记忆: -
Batch Norm $=$ 固定通道,跨样本归一化;
-
Layer Norm $=$ 固定样本,跨所有通道归一化;
-
Instance Norm $=$ Layer Norm 去掉跨通道,对每个通道单独归一化;
-
Group Norm $=$ 介于 Layer Norm 与 Instance Norm 之间,把通道分成若干组,组内归一化($G=C$ 退化为 Instance Norm,$G=1$ 退化为 Layer Norm)。
站在"抹平什么、保留什么"的角度,其分别的作用是:
- Layer Norm:抹去了同一类别不同样本的特征向量差异,保留了同一样本不同通道的特征向量差异——因此它不会利用批内其他样本的信息,天然适合序列建模与自回归解码。
- Batch Norm:抹去了同一样本不同通道的特征向量差异,保留了同一类别不同样本的特征向量差异——因此它对 batch 组成敏感,换来的是批统计量带来的正则化与训练加速。
- Instance Norm:抹去了单个样本内部的均值与对比度(即"风格"),保留了通道间的相对结构,故常用于风格迁移。
- Group Norm:用分组的方式在小 batch 下折中——既有通道分组带来的稳定统计量,又不像 Batch Norm 那样强依赖 batch 大小。
SNN 中的归一化
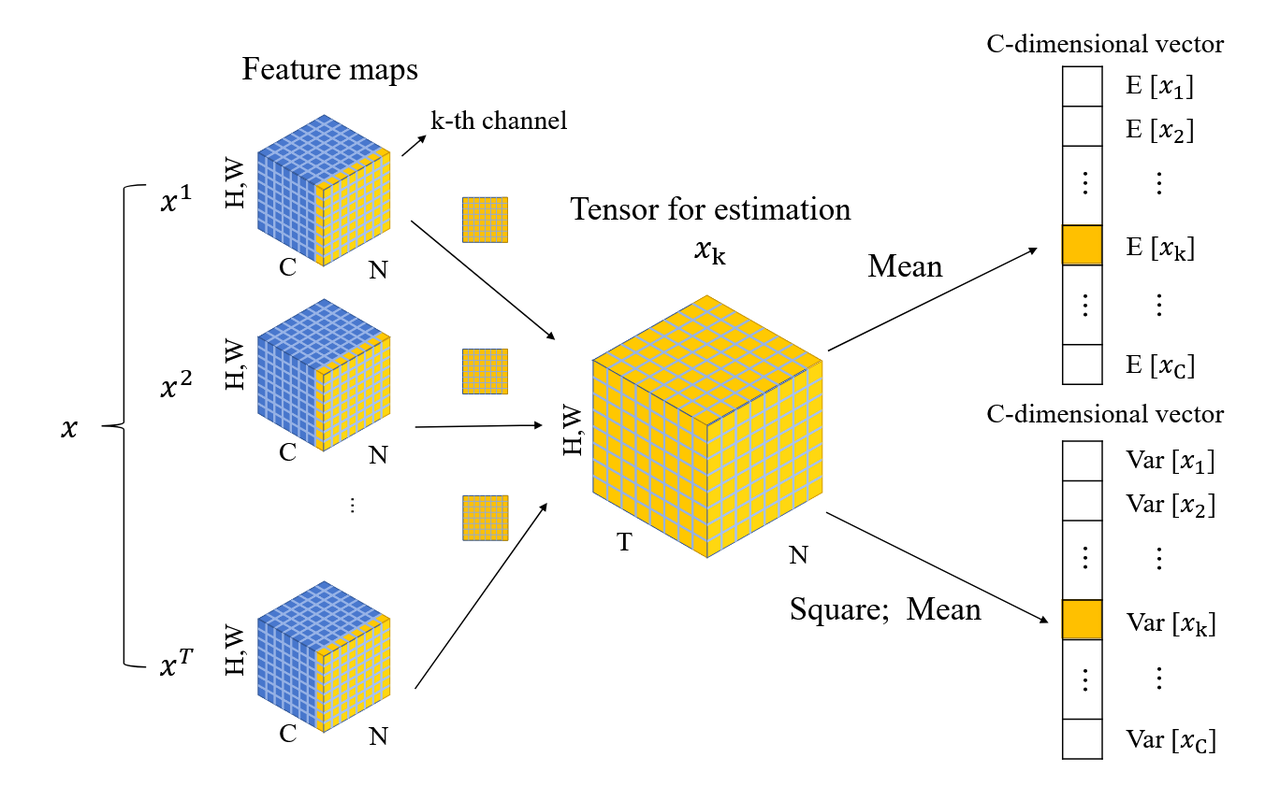
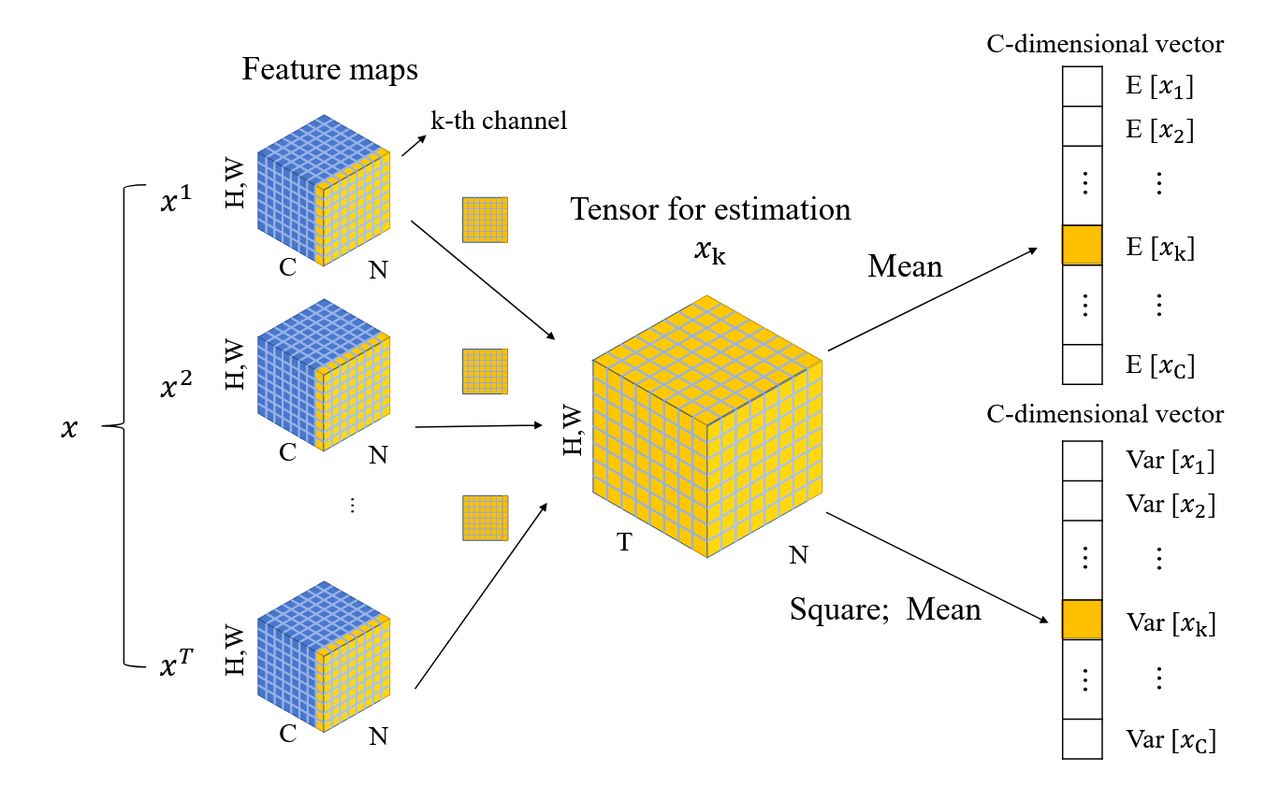
在 SNN 中,网络每层传递 0/1 脉冲值,不再是连续的实值,因此归一化在此处可以结合频率分布来理解,即 ANN 中的激活数值大小可以理解为 SNN 中的神经元发放脉冲频率大小,ANN 中的"特征向量"对应 SNN 可理解为"频率向量"。tdBN(Going Deeper With Directly-Trained Larger Spiking Neural Networks)被提出,其公式原理如下所示:
$$
Y_{t}=\lambda\cdot\frac{X_{t}-\mu_{c}}{\sqrt{\sigma_{c}^{2}+\epsilon}}\cdot\gamma_{c}+\beta_{c},\qquad \mu_{c}=\frac{1}{NTHW}\sum_{n,t,h,w}X_{n,t,c,h,w}
$$
其中 $X_{t}$ 为第 $t$ 时刻该层的膜电位(BN 之前的线性输出),$T$ 为仿真时间步,$\lambda$ 为神经元发火阈值。与普通 BN 相比,tdBN 有两点关键改动:
- 统计维度多了时间轴 $T$:在每个通道上跨 batch、跨时间、跨空间求均值方差,相当于对整段时空的膜电位分布做统一规范;
- 乘以阈值 $\lambda$:使归一化后的分布与发火阈值处于同一尺度,从而将膜电位的整体分布"框定"在阈值附近。原文证明,这样能把深层膜电位稳定在阈值附近的合理区间,避免因分布漂移导致神经元要么不发放、要么饱和发放。
加入了时间维度归一化信息,能规范调整频率分布:
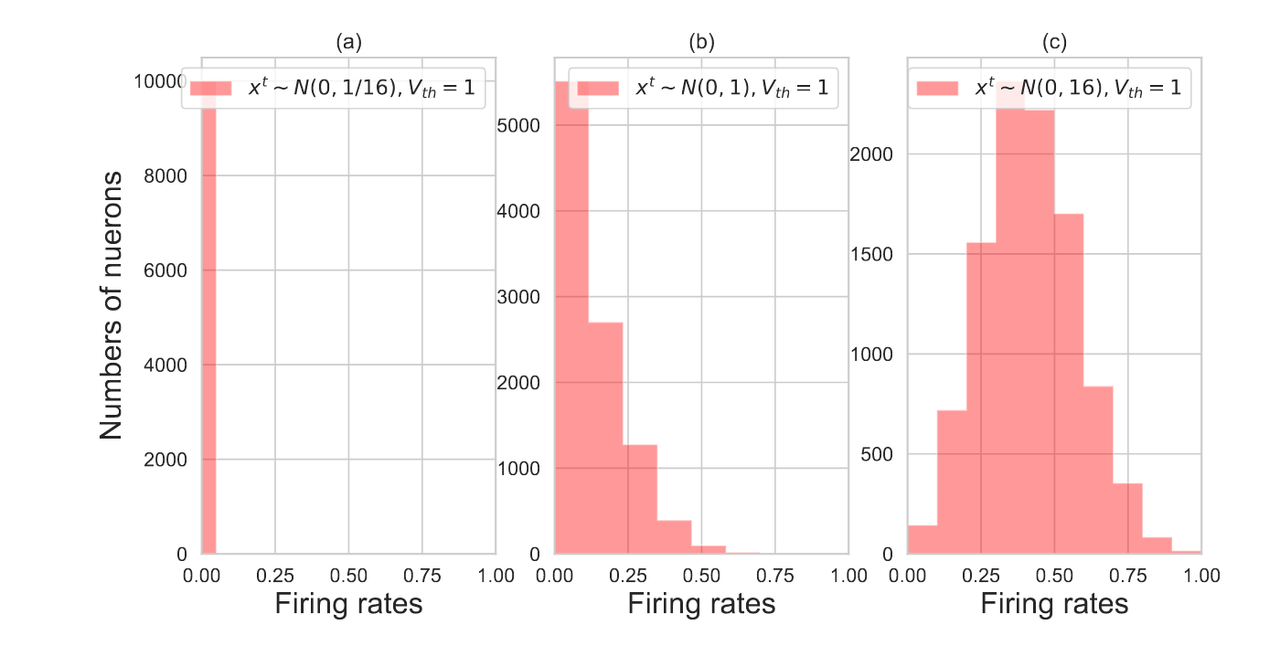
- 未采用 tdLN

- 采用 tdLN
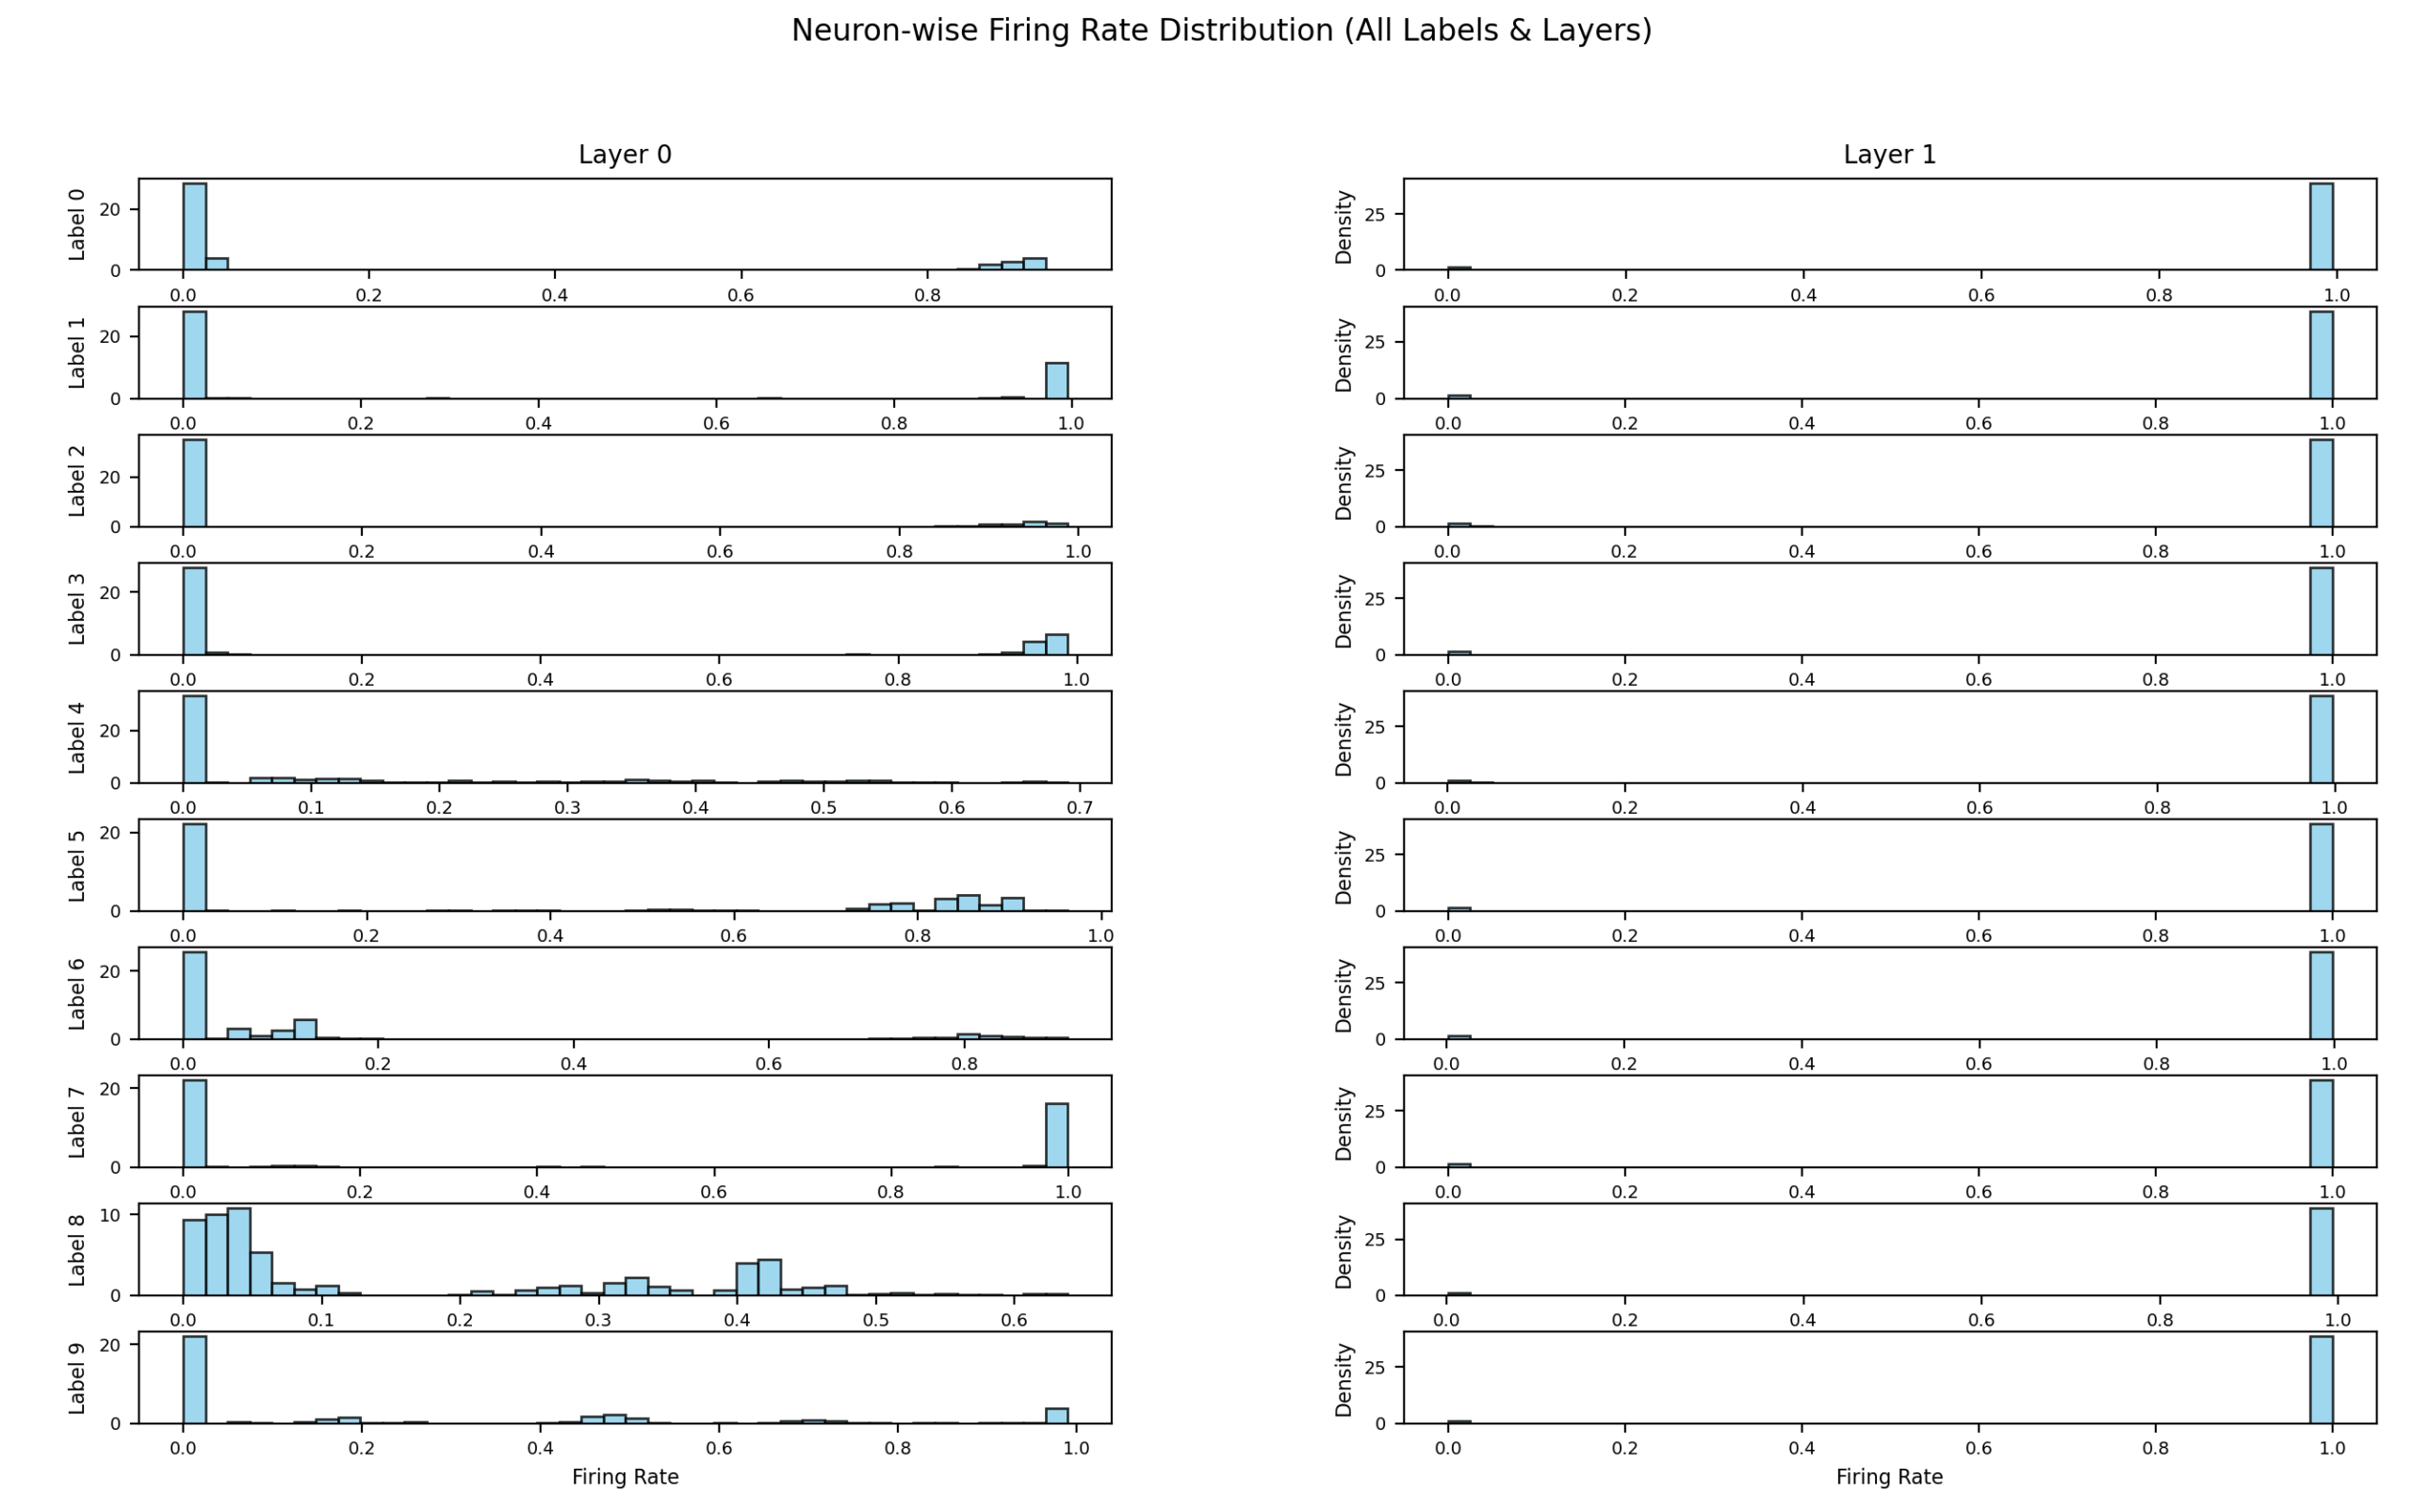
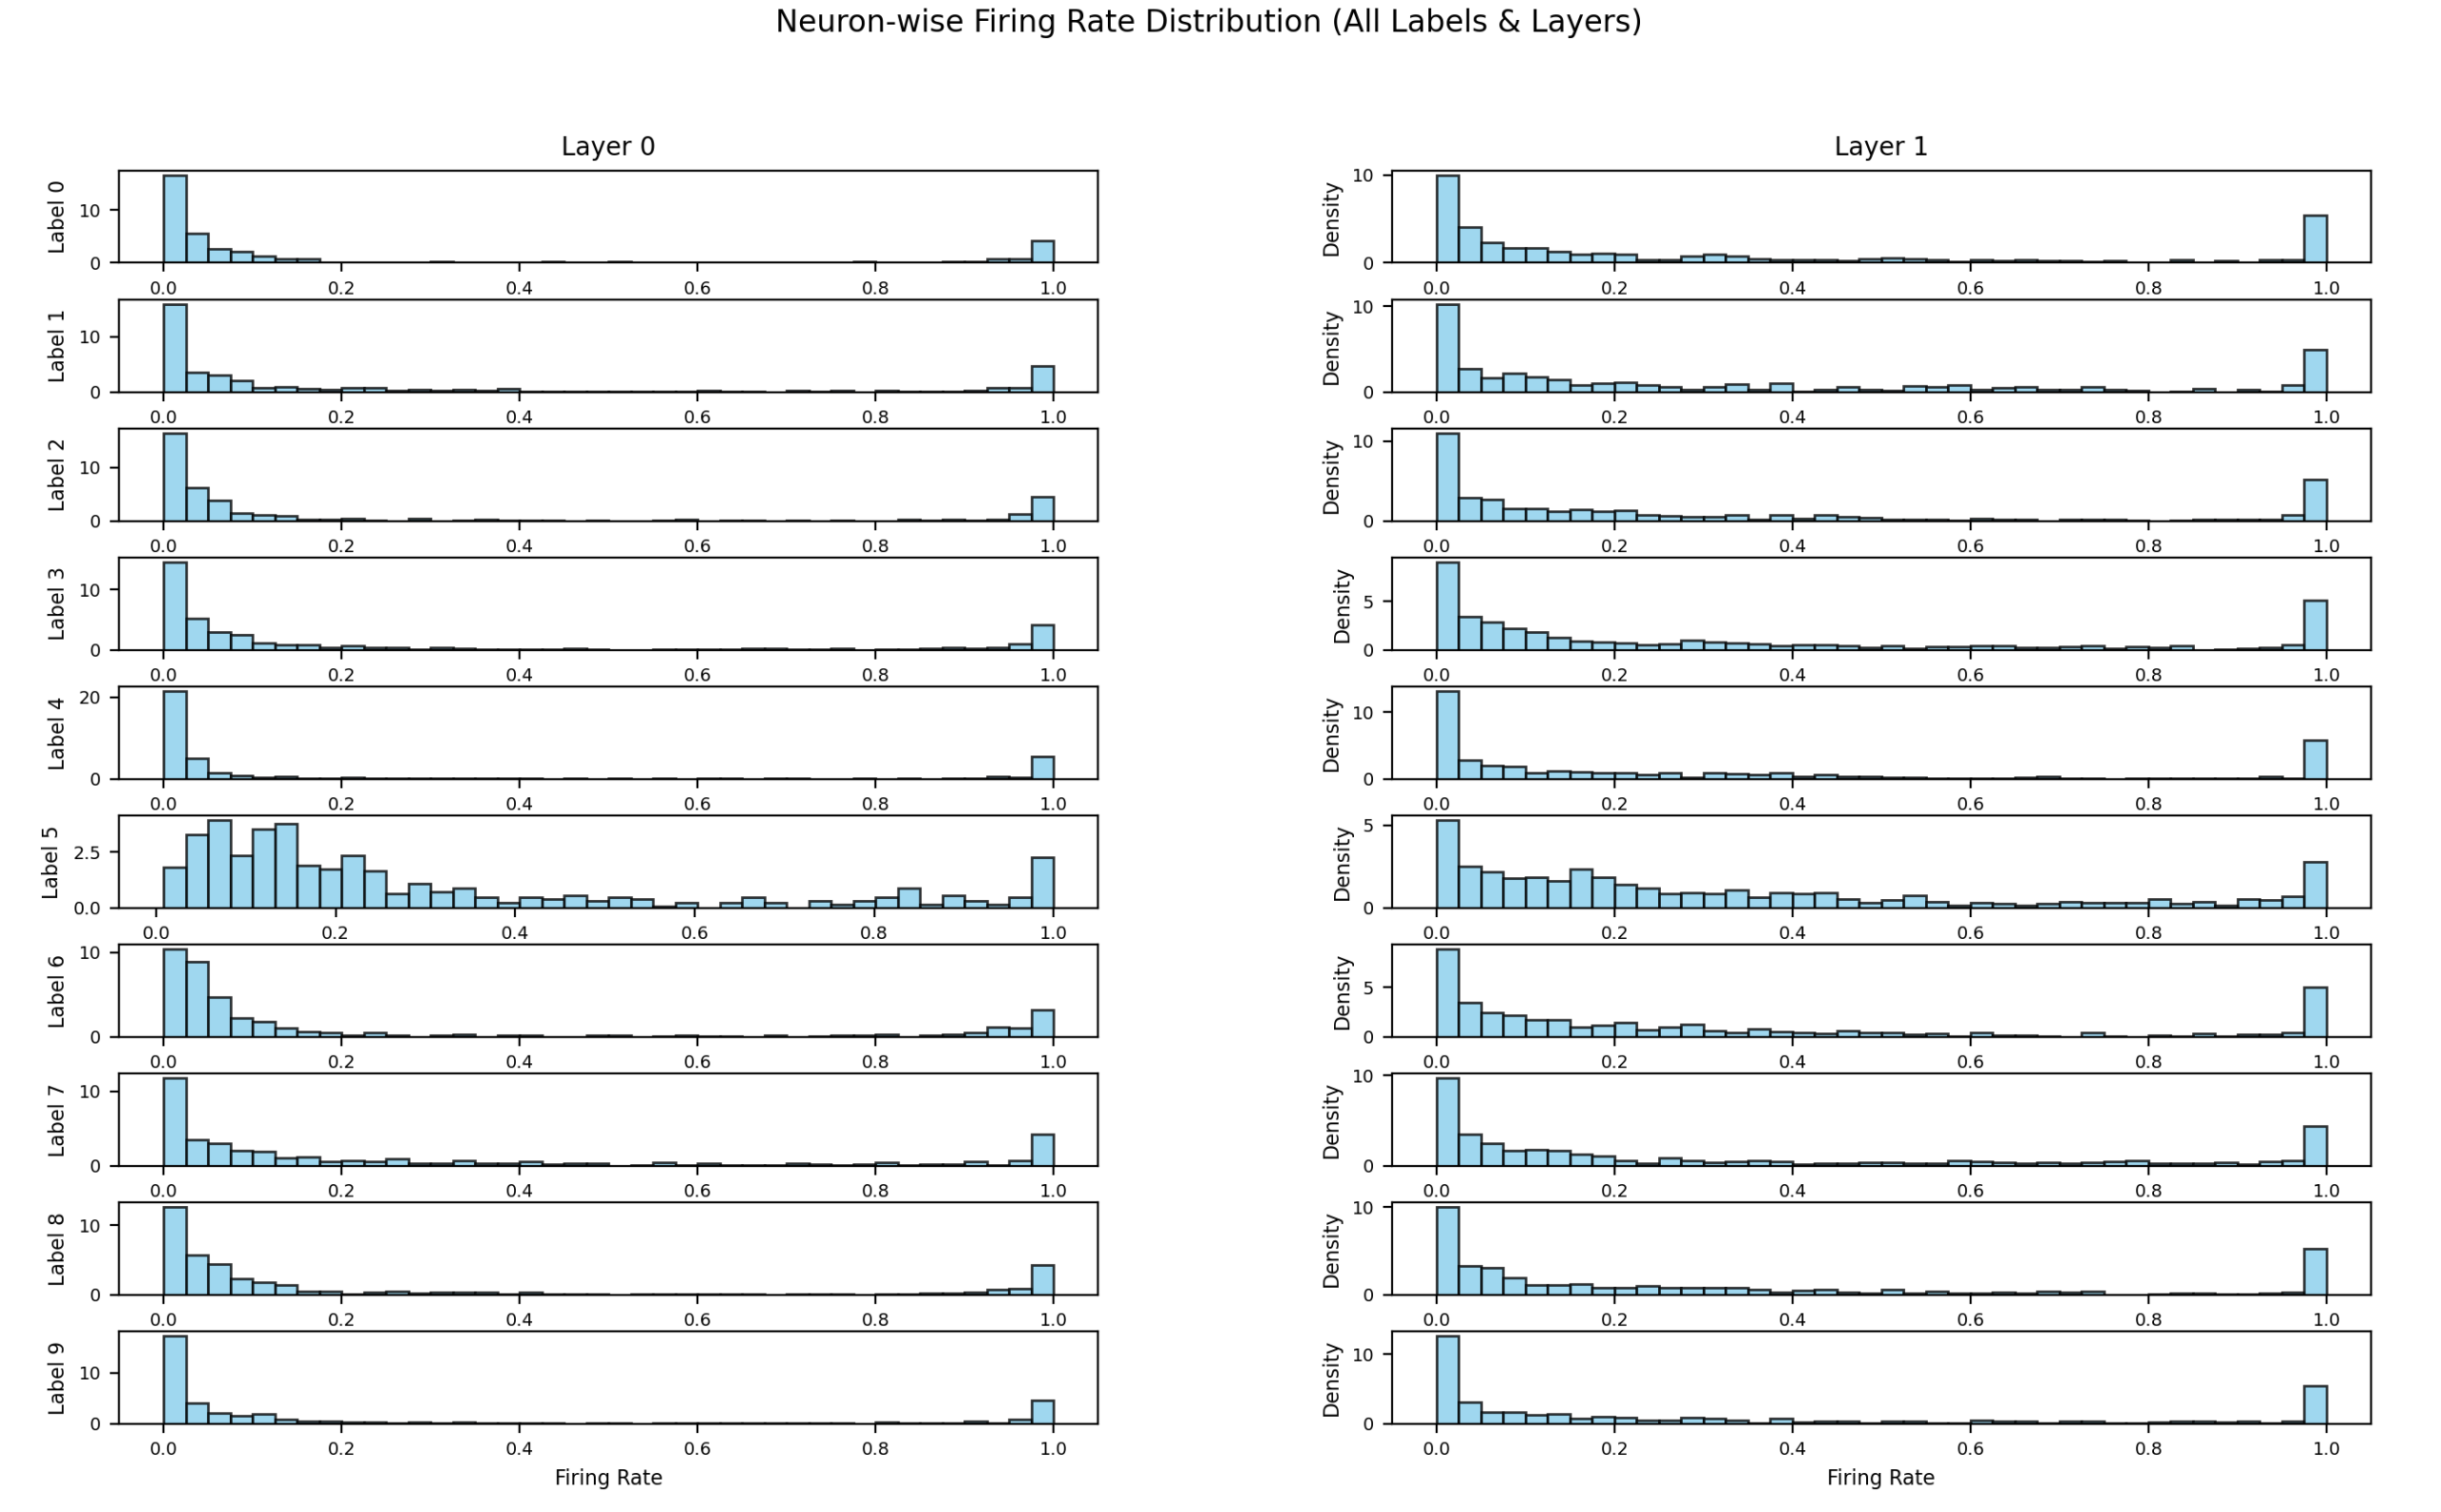
可以看到使用 tdLN 后,每一层的输出频率分布比较接近 [[Pasted_20260910175118_浅析深度学习中的归一化.png | 归一化频率分布示意图]](b),避免逐层传递发生偏移,影响模型表现力。
不同归一化对算法影响
本人在学习前向前向传播(Forward-Forward,FF)算法与实验中,发现归一化的选取成为了制约模型学习能力因素之一,具体如下:
模型需要理解同一类别下不同样本的差异,即泛化性能力,才能更好地将同类别的样本点汇聚,进而提升性能。
FF 的判据 goodness 是逐样本计算的(每个样本各算各的隐藏层激活平方和);而归一化加在哪一步,决定了交叉样本的差异是被保留还是被抹除——若它直接作用在 goodness 所度量的那个向量上,每个样本的幅值都会被压成常数,差异自然读不出来。所以先要问的不是"用 LN 还是 BN",而是"差异信息由谁提供、归一化又加在哪一步"。
- 前向前向正负样本学习
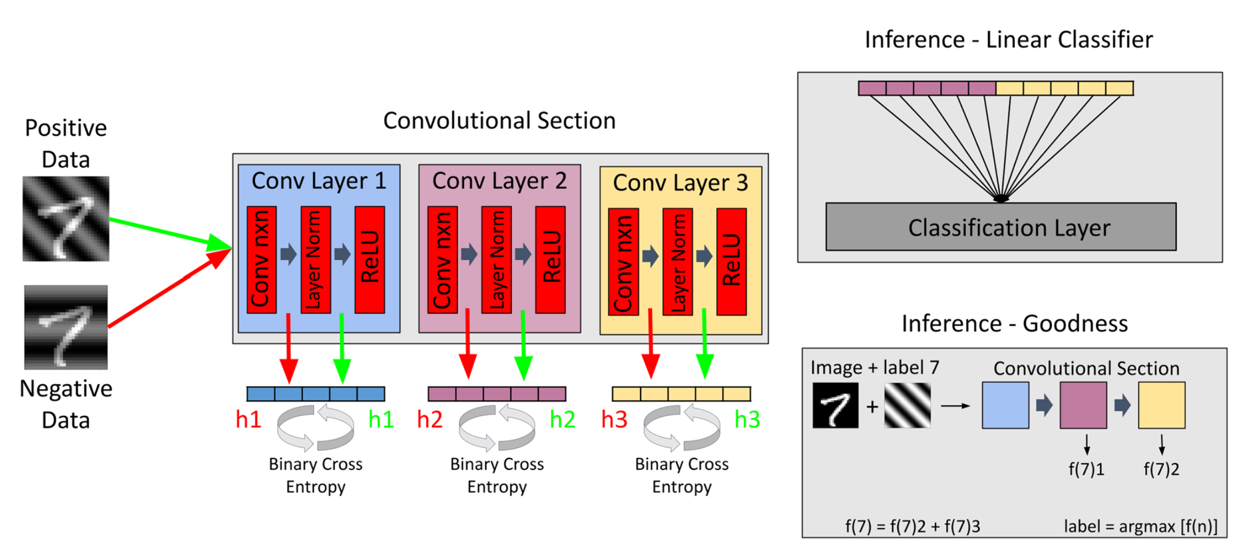
在该模式下,正负样本的对比隐含了同一类别不同样本的差异信息,在多次对比学习当中,能够使模型理解同一类别下不同样本的差异。而 goodness 是逐样本的判据,要让判据只比"方向/模式"、不比"幅值",就必须先把幅值归一掉——这一步天生是逐样本的。因此此处选用 LN:它不引入任何批统计量,保证 goodness 逐样本可比,干净地解耦各层;若改用 BN,批统计量会混进每个样本的输出,破坏 FF"每个样本独立计算"的前提。
- 单次前向局部学习
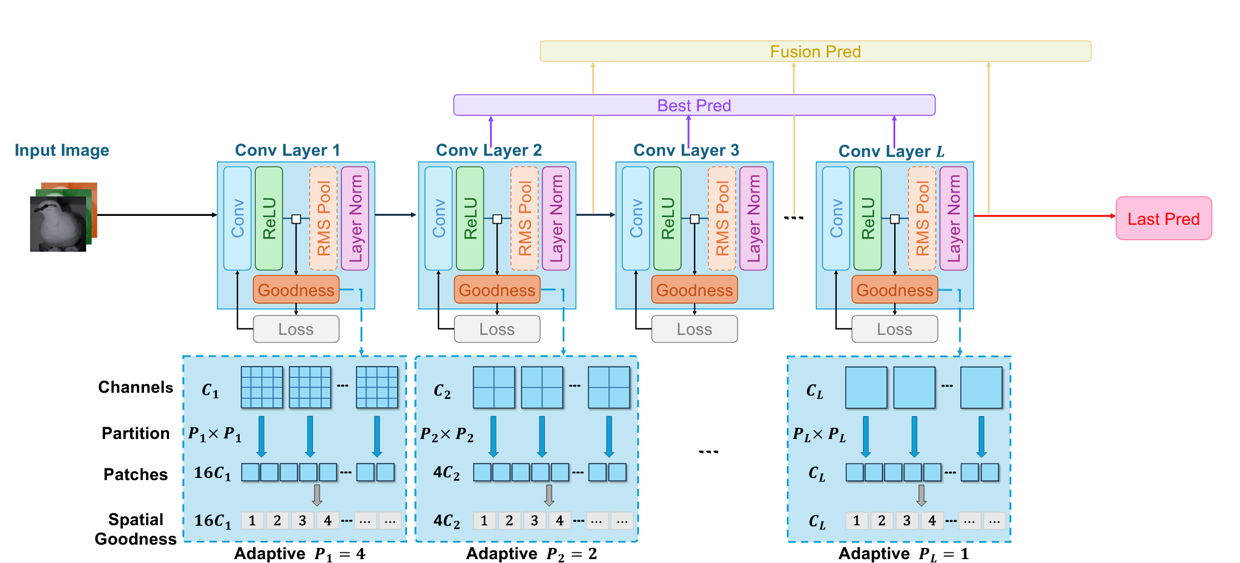
而在单次前向中,没有负样本的对比,算法不再显式注入类内差异信息,采用 LN 会让同类别的样本在归一化后趋于一致,模型性能容易受限;改用 BN,相当于把"读差异"的维度从样本内部放宽到整个批次——批统计量成了类内差异的载体,模型据此获得类内结构的线索,性能可以进一步提升。但 BN 并非无条件更优:它依赖 batch 足够大、且批内采样到同类别的多个样本;一旦 batch=1 或批内同质,BN 就退化为 Instance Norm,这份信息同样会消失,还要额外付出训练/推理统计不一致的代价。
这说明:归一化方法没有绝对优劣,选哪种取决于算法能从哪个维度获取"同一类别不同样本的差异"信息。当算法本身已经通过正负样本对比引入了这种差异时,用 LN 保持逐样本、干净地解耦各层即可;当算法只有单次前向、缺乏对比信号时,才需要 BN 把读取维度放宽到批次,保留批内样本差异。
总结
- 归一化的本质是主动设计激活的分布。它通过"减均值、除标准差、再仿射"三步,把每层输入重新拉回稳定的尺度,缓解内部协变量偏移,平滑损失曲面,从而支持更大的学习率与更深的网络。
- 不同归一化方法的差异,只在于"沿哪些轴求统计量"。Batch Norm 跨样本、Layer Norm 跨通道、Instance Norm 单通道内、Group Norm 分组折中。换个说法就是:抹去哪些维度的差异,保留哪些维度的差异——这决定了它适合什么样的任务。
- 可学习参数 $\gamma,\beta$ 是归一化不可省略的一半。它们让网络在需要时能把归一化"撤销"回恒等映射,保证归一化只提供更友好的优化起点,而不强制牺牲表达能力。
- 在 SNN 中,归一化的对象从"激活幅值"变成"脉冲频率分布"。tdBN 把 Batch Norm 拓展到时空维度并乘以阈值 $\lambda$,将膜电位分布稳定在阈值附近,使深层网络的频率分布保持一致,避免逐层漂移损害模型表现力。
- 方法的选择是算法相关的。FF 算法的正负样本学习用 LN 保持逐样本、解耦各层即可,而单次前向局部学习则靠 BN 把读取维度放宽到批次、保留同类内差异(且需注意其对 batch 大小的依赖)。脱离具体算法谈"哪种归一化更好"是没有意义的。
一句话收束:归一化不是简单地"把数值压小",而是一种在层与层之间搬运和取舍信息的机制——你选择在哪个维度归一化,就等于选择了让模型记住什么、忘记什么。
那么,在色彩斑斓的取向下,归一与归零,你选哪一个?
$$